Incidents et runbooks
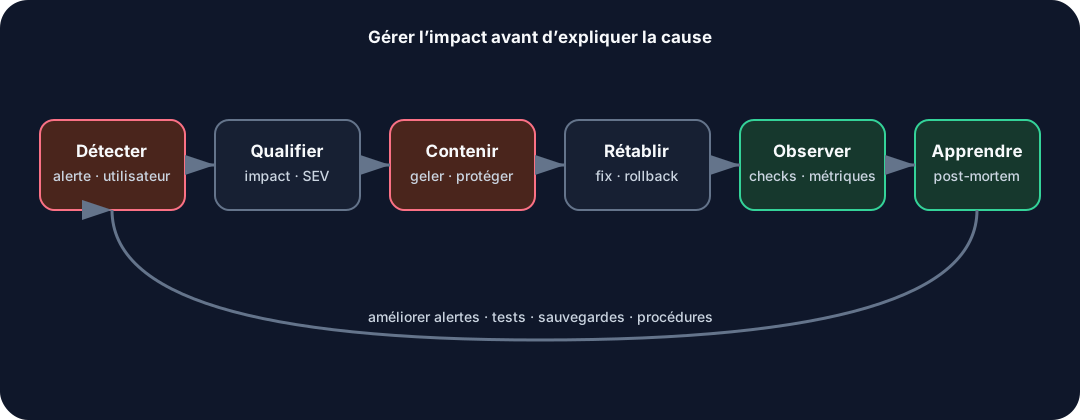
L’objectif initial n’est pas d’expliquer toute la cause, mais de limiter l’impact sans détruire les preuves ni aggraver les données.
Sévérité
Section intitulée « Sévérité »| Niveau | Exemple | Réponse |
|---|---|---|
| SEV-1 | production inaccessible, perte ou corruption probable | action immédiate, gel des changements, communication fréquente |
| SEV-2 | fonction majeure indisponible, contournement limité | prise en charge prioritaire et suivi régulier |
| SEV-3 | dégradation localisée ou intégration externe | correction planifiée, surveillance |
| SEV-4 | anomalie sans impact utilisateur immédiat | ticket et traitement normal |
Adaptez la sévérité à l’impact réel, au nombre d’utilisateurs, à la durée et au risque sur les données, pas seulement au caractère impressionnant d’une trace.
Première réponse
Section intitulée « Première réponse »- Notez heure de détection, environnement, domaine, SHA et dernier changement connu.
- Désignez un responsable de l’incident.
- Gelez les déploiements non liés.
- Déterminez si les données sont en danger ; bloquez les écritures concernées si nécessaire.
- Capturez logs assainis, état des conteneurs et métriques avant redémarrage.
- Choisissez contention, rollback ou restauration selon le type de changement.
- Communiquez impact, contournement et prochain point, sans spéculer.
Arbre de diagnostic
Section intitulée « Arbre de diagnostic »Le domaine répond-il ?├─ non → DNS → certificat → Traefik/Dokploy → conteneur → port└─ oui ├─ 502/504 → processus, bind 0.0.0.0, port interne, réseau, health check ├─ 5xx → logs application, configuration, migration, dépendance externe ├─ page vide/SSR → web, API_BASE_URL, contrat backend └─ fonction isolée → autorisation, donnée, e-mail/calendrier/média/IARunbook : Bad Gateway backend
Section intitulée « Runbook : Bad Gateway backend »- Confirmez que le conteneur est en cours d’exécution, pas seulement construit.
- Lisez les dernières lignes de démarrage et recherchez une configuration invalide.
- Vérifiez que le processus écoute sur
0.0.0.0:8090. - Testez
/api/healthdepuis le réseau interne. - Contrôlez le port configuré dans le domaine Dokploy.
- Vérifiez droits et montage de
/app/pb_data. - Si l’image précédente fonctionne avec le même volume, évaluez un rollback de code.
Runbook : certificat invalide ou expiré
Section intitulée « Runbook : certificat invalide ou expiré »- Relevez le certificat effectivement présenté et l’heure du serveur.
- Vérifiez A/AAAA et l’absence d’ancienne IP.
- Contrôlez l’accès public aux ports
80/443. - Lisez les erreurs ACME de Traefik et identifiez domaine, challenge et limite éventuelle.
- Corrigez DNS/routage/permissions, puis relancez un renouvellement ciblé.
Runbook : web indisponible, backend sain
Section intitulée « Runbook : web indisponible, backend sain »- Testez le health backend depuis l’extérieur puis depuis le conteneur web.
- Vérifiez
API_BASE_URL, DNS interne et certificat amont. - Cherchez une incompatibilité entre SHA web et contrat backend.
- Inspectez les logs SSR ; un navigateur peut recevoir une erreur rendue côté serveur.
- Contrôlez le runtime/adaptateur, le port et la commande de démarrage du web.
- Revenez au dernier SHA web sain si aucune donnée n’est impliquée.
Runbook : volume ou base
Section intitulée « Runbook : volume ou base »Si le backend démarre avec une base vide, arrêtez les écritures immédiatement. Vérifiez le montage du volume avant toute création de données. Ne copiez pas une base de production par-dessus le volume actuel sans conserver ce dernier et sans tester la restauration dans un volume isolé.
En cas d’erreur SQLite : contrôlez espace disque, droits UID 1000, fichiers du volume et derniers
événements. Un redémarrage répété peut masquer le premier message utile.
Runbook : e-mails en échec
Section intitulée « Runbook : e-mails en échec »- Vérifiez que la demande a bien été persistée.
- Consultez le statut et la dernière erreur d’envoi, sans exposer le contenu personnel.
- Contrôlez
configs/email, DNS et disponibilité SMTP. - Corrigez la cause puis utilisez la relivraison prévue par le back-office.
- Évitez de recréer la demande, ce qui peut produire des doublons.
Un incident est clos après rétablissement, fenêtre de surveillance et consignation de :
- impact et durée ;
- chronologie factuelle ;
- cause technique et facteurs contributifs ;
- données perdues ou non, clairement établies ;
- action de restauration/rollback ;
- mesures empêchant la récidive, avec propriétaires et échéances.
Le post-mortem ne cherche pas un coupable. Il doit améliorer les garde-fous, alertes, tests, sauvegardes ou procédures qui auraient réduit l’impact.